
把完成某类任务的说明、脚本、模板和检查方法封装成可复用模块,让智能体在需要时加载,而不是每次从头摸索或把所有知识都塞进上下文。
Research Topic 04 · Agent Skills
Agent Skills:是什么、怎么用、怎样改进
从技能的定义、生成与检索,到效果评测、安全风险和持续改进,建立一条可以顺着读、也可以按问题查阅的研究路径。
1个完整技能周期
6个学习阶段
51篇论文辅助解释
2023–2026研究跨度
入门导读
51 篇论文辅助解释
先用一分钟理解这个专题
Agent Skill 是供智能体执行特定任务时调用的可复用任务模块,通常包含操作说明、脚本、模板和适用条件。以表格处理为例,它会明确何时调用电子表格工具、按什么步骤完成操作,以及如何检查结果。Agent Skill 不修改模型参数,而是在任务执行时按需加载,为智能体补充特定任务所需的流程和资源。
本专题整理了 51 篇论文,分成六部分:Skill 是什么、怎样产生、怎样查找和组合、怎样评测、有哪些安全风险,以及怎样持续改进。比较论文时,需要把模型本身、运行智能体的系统(Harness)和 Skill 分开看,避免把模型升级或工具变化误算成 Skill 的效果。
目前常见的做法有两类。一类从成功的执行记录、长期记忆或人工经验中总结出可重复的步骤;另一类研究技能库变大后,智能体怎样选对技能、安排多个技能的执行顺序,并根据当前工具和环境做调整。Voyager、SkillWeaver 和 SkillCorpus 分别展示了技能积累、自动发现和公开技能库整理。
写出一个 Skill 不代表智能体就会正确使用。Skill-Use 把问题分成是否正确触发、是否按步骤执行、是否遵守限制,最强配置的总分仍只有 0.613;Regression Tax 还发现,加入技能有时会让原本能完成的任务变差。因此每次新增或修改技能,都需要独立评分、使用未参与修改的测试题,并保留版本记录和回滚机制。
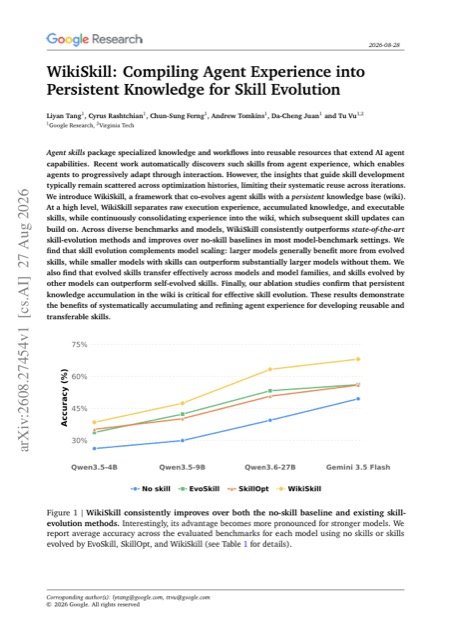
工程上不应追求技能数量越多越好,而应关心它是否容易找到、能否稳定执行、出了问题能否定位和删除。自动改进也不能只看一次成功记录:候选修改应先在新任务上测试,同时检查成本和安全,再决定是否写入正式技能库。WikiSkill 进一步说明,执行记录和正式技能之间需要可持续整理的知识层,帮助后续更新复用旧经验。
关键词:Agent Skills;SKILL.md;程序性知识;技能检索;轨迹挖掘;技能评测;回归测试;自进化
本页怎么学:先分清 Skill、提示词、工具和模型,再沿“产生 → 检索 → 执行 → 评测 → 更新”理解完整生命周期;最后用净收益、能力回退和供应链风险判断一次更新是否值得保留。论文摘要用于查看各环节的代表方法。
TOPIC LESSON · 专题学习
先把专题学明白,再用论文核验
Agent Skills 把流程、脚本和资源封装成按需加载的能力模块。阅读本专题时应围绕完整生命周期来组织:如何产生、如何选用、是否产生净收益,以及更新后能否安全回滚。
它更像可执行的标准作业程序,而不是一句提示词:既说明何时使用,也给出步骤、依赖资源和完成后的检查方式。
不要把模型升级、工具可用性变化或一次成功轨迹直接当作 Skill 的稳定贡献。
Skill 是任务知识包,不是模型或工具本身
模型负责理解与生成,工具负责实际操作,Skill 则把触发条件、操作步骤、脚本资源和结果检查组织起来,供智能体按需加载。
记住一个好 Skill 既要告诉智能体怎么做,也要告诉它什么时候不该用。
技能写得好,还要能够被正确找到和组合
当技能库变大时,系统需要先检索到合适的模块,再根据当前工具、文件和约束执行;多个 Skill 同时出现时,还可能产生顺序或规则冲突。
记住Skill 的质量、检索质量和执行遵从度是三个不同问题。
新增能力要看净收益,而不是只看新任务
自动生成或更新 Skill 后,既要测试它是否解决目标任务,也要检查旧任务是否退化、权限是否扩大、内容是否被污染,并保留版本与回滚机制。
记住技能越多不一定越好;可发现、可验证、可删除比数量更重要。
专题图解接着上方图 1,按图 2 → 图 3 顺序阅读
Topic review & recent work
专题综述与最新研究
智能体技能(Agent Skill)正从人工编写走向生成、检索与持续改进
Skill 把任务说明、脚本和检查步骤封装成按需加载的能力模块。研究焦点已经从“能否复用经验”转向“怎样选对技能、避免能力回退,并在自动更新后保留可追踪的版本和验证记录”。
- 先区分 Skill、提示词、工具和长期记忆
- 再看技能怎样从执行记录中生成和检索
- 最后用净收益、能力回退和安全边界评价自动更新
最新研究按收录时间排序
WikiSkill: Compiling Agent Experience into Persistent Knowledge for Skill Evolution
Liyan Tang、Cyrus Rashtchian、Chun-Sung Ferng、Andrew Tomkins、Da-Cheng Juan、Tu Vu
TRUSS: Towards Task-Reliable and User-Safe Automated Agent Skill Generation
Zhibo Zhang、Zhen Ouyang、Ling Shi、Kailong Wang
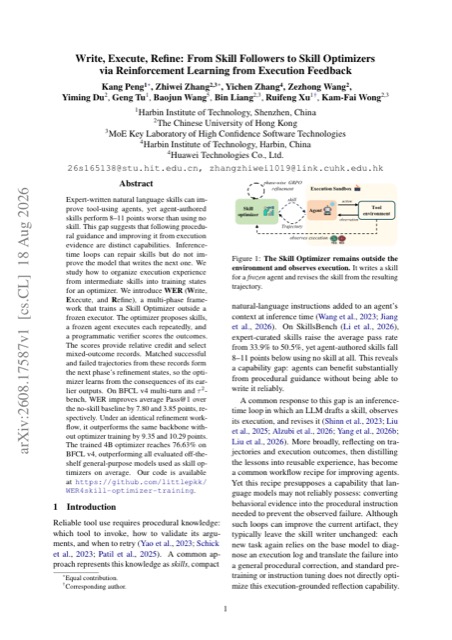
Write, Execute, Refine: From Skill Followers to Skill Optimizers via Reinforcement Learning from Execution Feedback
Kang Peng、Zhiwei Zhang、Yichen Zhang 等
研究方向脑图
Agent Skills 研究覆盖一个完整生命周期:技能如何产生、被找到、可靠执行,并在验证后持续更新。
核心问题把可复用能力封装成 Skill
由触发条件、操作说明、脚本、资源和结果检查共同组成
定义与生态
区分 Skill、提示词、工具和模型能力,并研究可移植的描述与封装格式。
发现与生成
从任务、轨迹或人工经验中发现可复用步骤,自动生成候选技能。
检索、路由与组合
让智能体在合适时机找到正确 Skill,并组合多个技能完成复杂任务。
执行与效果评测
衡量任务收益、成本、失败模式和能力回退,判断技能是否真的有用。
安全与供应链
检查恶意说明、依赖风险、权限扩大、数据泄漏和技能间冲突。
持续改进
根据新任务和失败轨迹修订 Skill,通过独立测试、版本管理和回滚发布更新。
论文摘要与延伸阅读
当前展示 51 篇:19 篇核心精读,32 篇延伸阅读
01
READING STAGE 01
先认识 Agent Skills
先弄清 Agent Skill 是什么、通常包含哪些文件,以及公开技能库现在有多大、质量如何。
9 篇
arXiv
2023
定义与生态
Toolformer: Language Models Can Teach Themselves to Use Tools
论文摘要
Toolformer 用少量 API 示例让模型自行标注何时调用工具、传什么参数以及怎样接回结果,再用筛选后的调用轨迹继续训练。它还不是 SKILL.md 式技能包,但它是“模型自主发现并内化可复用外部能力”的关键前身。
arXiv
2023
定义与生态
Voyager: An Open-Ended Embodied Agent with Large Language Models
论文摘要
Voyager 在 Minecraft 中把验证过的复杂行为保存为可执行代码库,按新任务检索和组合,并通过自动课程探索、环境反馈和自验证来迭代程序。它展示了一个不更新模型权重也能持续积累和复用技能的早期完整系统。
arXiv
2026
定义与生态
Agent Skills for Large Language Models: Architecture, Acquisition, Security, and the Path Forward
论文摘要
这篇综述把 Agent Skill 定义为可组合的指令、代码和资源包,按架构、获取、部署与安全四条线梳理领域,并提出按来源和权限分级的信任模型与生命周期管理方案。
arXiv
2026
定义与生态
A Comprehensive Survey on Agent Skills: Taxonomy, Techniques, and Applications
论文摘要
综述把 Agent Skill 定义为在任务约束下协调工具、记忆与运行上下文的可复用程序单元,用表示、获取、检索和进化四个阶段串联方法、数据集与开放问题。
arXiv
2026
定义与生态
SkillCorpus: Consolidating and Evaluating the Open Skill Ecosystem for Real-World LLM Agents
论文摘要
SkillCorpus 从约 82.1 万条公开技能中去重过滤得到 96,401 条,按 16 类任务和效用、稳健性、安全三项维度组织。实验显示检索技能库能改善真实任务,但收益受语料覆盖和执行环境限制。
arXiv
2026
定义与生态
Skillware: A Software Ontology and Engineering Lifecycle for Persistent Behavioral Artifacts
论文摘要
Skillware 把 Agent Skill 定义为持久化的行为单元:Skill Artifact 描述任务行为,Skillware Unit 管理版本与更新,Agent Host 负责运行时激活。论文用行为优先、独立身份和宿主执行三项条件区分它与提示词或工具。
arXiv
2026
定义与生态
What Keeps Agent Skills from Being Reusable? Evidence from 138K SKILL.md Files
论文摘要
论文审计 138,133 个公开 SKILL.md,发现 91.8% 至少有一种缺陷,主要是路由信息薄弱、正文臃肿或不可执行、资源组织差,而非复杂攻击。规范生成、自动检查和修复可改善可复用性。
arXiv
2026
定义与生态
GitSkills: A Dataset of Agent Skills on GitHub
论文摘要
GitSkills 从 282,200 个公开仓库收集 3,797,117 个 SKILL.md 文件,保留路径、内容哈希、目录资源和提交历史,为研究技能复用、维护和供应链安全提供可查询数据。
arXiv
2026
定义与生态
Demystifying Agent Skills: Why They Work-Until They Don't
论文摘要
论文在多个基准和模型上整理 8,135 条试验记录,提出 12 种技能使用模式。结果显示,技能主要靠固定执行流程来稳定行动,而非注入新知识;当技能池变大或上下文不兼容时,检索和适配会各自导致失败。
02
READING STAGE 02
技能怎么产生
研究怎样从探索记录、长期记忆和执行反馈中总结出可复用的方法,并写成文档、代码或参数。
9 篇
arXiv
2023
发现与生成
Large Language Models as Tool Makers
论文摘要
LATM 把能力获取拆为一次性的工具制作与反复的工具使用:强模型为一类任务编写并验证可复用工具,较小模型随后通过 API 调用。它把自然语言经验变成可缓存的程序能力,是从工具使用走向技能生成的重要桥梁。

arXiv
2025
发现与生成
SkillWeaver: Web Agents can Self-Improve by Discovering and Honing Skills
论文摘要
SkillWeaver 让网页智能体探索陌生网站、发现可复用交互模式,再通过反复练习把经验提炼成轻量 API。技能库随探索扩展,并可从强智能体迁移给弱智能体,实现不更新权重的自我改进。
arXiv
2026
发现与生成
Automating SKILL.md Generation for Computer-Using Agents via Interaction Trajectory Mining
论文摘要
这项研究把 GUI 交互记录切分、聚类成候选技能,再训练感知技能的策略。五个聚类在源任务上纯度不低于 0.95,但下游准确率只从 18.5% 提至 20.5%,跨域几乎无改善,说明可读结构不等于可迁移能力。
arXiv
2026
发现与生成
From Memory to Skills: Evidence-Grounded Co-Evolution Governance for Long-Horizon LLM Agents
论文摘要
MSCE 把很长的执行记录分成具体步骤、可复用方法和环境信息,只把确实带来提升、并写清适用范围与检查方法的策略保存成技能。这样,智能体不会把每段历史记录都误当成以后应该照做的规则。
arXiv
2026
发现与生成
Agent Skills Matter: Inferring Proprietary Skills from Execution Trajectories
论文摘要
论文把云端智能体的执行记录当作能力泄露面,研究能否从输入、动作、工具调用和结果中反推出未公开的技能。这把技能获取从自有经验扩展到行为重建,也暴露了商业技能的知识产权风险。
arXiv
2026
发现与生成
SkillSmith: Learning to Compose Parametric Skills and Textual Knowledge
论文摘要
SkillSmith 把 prefix-tuning(一种只微调模型前缀参数的方法)得到的权重视为新输入,让模型同时读取参数化技能与文本说明,一次生成目标前缀,尝试组合自然语言知识与权重空间能力。
arXiv
2026
发现与生成
Progressive Agent Skill Generation via Reinforcement Learning
论文摘要
这项研究把技能生成改成渐进式强化学习任务,让生成器从任务说明、执行记录和反馈中学习写草稿、验证和继续修改。目标是用同一套训练方法处理不同来源的经验,减少为每类任务单独设计流程的工作。
arXiv
2026
发现与生成
Learning Globally Reusable Skills for Coding Agents
论文摘要
论文指出编码智能体针对单次任务局部修改技能容易产生冲突补丁,因此从跨项目执行记录中学习全局可复用的程序知识,并用跨任务验证判断新规则是否应合并进共享技能。
arXiv
2026
发现与生成
TRUSS: Towards Task-Reliable and User-Safe Automated Agent Skill Generation
论文摘要
TRUSS 把自动技能生成的目标从任务成功扩展为可靠性与安全双约束,要求同时产出程序指导、可执行资源和安全边界,并用执行测试与风险检查过滤表面有效但不可信的技能。
03
READING STAGE 03
技能怎么找到和配合
技能库变大后,智能体怎样选对技能、把多个技能按顺序接起来,并在执行中及时发现错误。
8 篇
arXiv
2026
检索与组合
OpenClaw-Skill: Collective Skill Tree Search for Agentic Large Language Models
论文摘要
让多个模型共同生成候选技能节点,再从质量和跨模型迁移性两方面集体评分,构造出一棵技能树。该树同时用于生成训练数据和强化学习中的多技能选择,避免智能体只依赖单一或次优技能。
arXiv
2026
检索与组合
SkillSight: Seeing Through Shared Descriptions for Accurate Skill Retrieval
论文摘要
很多技能的名称和简介很像,但实际步骤不同,智能体很容易选错。SkillSight 不只看标题,还比较技能正文、所需工具和操作限制,用这些更具体的信息提高相似技能之间的检索准确率。
arXiv
2026
检索与组合
HiSkill: Empowering LLM Agents with Hierarchical Skill Graphs
论文摘要
用有向层级图把高层技能、可执行原子操作(AtomicOp)及分解、时序、兼容等关系连起来。推理时只检索任务相关子图,帮助把文本描述的技能转化为环境中可执行的动作。
arXiv
2026
检索与组合
SkillTrace: Traversing a Query-Skill Graph for Composable LLM Agents
论文摘要
SkillTrace 把复杂请求和技能库连成一张查询—技能关系图,不再只找单个相关技能,而是沿依赖关系寻找一组技能。它重点解决复杂任务需要多个技能覆盖不同子目标、并按正确顺序执行的问题。
arXiv
2026
检索与组合
Field Aware Agent Skill Retrieval
论文摘要
把整个技能文件压成一个向量会混淆触发条件、代码正文、工具约束等不同字段。该工作对技能文档按字段分别表示和匹配,让检索器根据查询需要选用不同字段作为证据。
arXiv
2026
检索与组合
Comparative Approaches to Agent Retrieval over Large Skill Libraries
论文摘要
论文比较三种大规模技能检索方法:一次性加载全部技能、独立向量检索,以及带结构的多步选择。比较内容包括占用多少上下文、能否选对技能和能否排对执行顺序,说明技能库变大后不能只看检索准确率。
arXiv
2026
检索与组合
SkillAligner: Treating Retrieved Skills as Adaptable Drafts at Execution Time
论文摘要
检索到的技能语义相关不等于直接可用。该工作把技能当作可修改的草稿,在运行时根据当前输入、工具和环境约束做局部调整,并验证调整是否真正改善了执行效果。
arXiv
2026
检索与组合
SkillSentry: Reliable Skill Execution for LLM Agents via Runtime Assurance
论文摘要
SkillSentry 在多步技能执行中增加检查层:关键动作前核对前置条件、工具调用和当前状态,执行后再检查结果与限制。它要解决的是技能虽然选对了,却因中途偏离流程而没有被发现的问题。
04
READING STAGE 04
怎么判断技能有没有用
分别检查技能本身写得好不好、智能体有没有正确使用,以及加入技能后是否反而变慢或更容易出错。
8 篇
arXiv
2026
效果评测
AEVAL: From Anecdotal to Deterministic Testing for Agentic Skill Workflows
论文摘要
AEVAL 把过去“让智能体试一下”的演示式检查,改成代码变更后自动运行的持续集成(CI)测试。每个技能先声明评测规则,执行和评分分开,并记录智能体是否在测试中自我修正,避免它一边改答案一边给自己判通过。
arXiv
2026
效果评测
The Regression Tax: Decomposing Why Skills Help and Hurt LLM Agents
论文摘要
用近6,000次运行统计技能带来的新增成功与能力回退,发现好技能的关键往往不是多解决了多少任务,而是对原本能完成的任务破坏更少。三类回退来自描述渗透、输入落地(grounding)被流程替代、验证步骤被抑制。
arXiv
2026
效果评测
ContinualSkillBench: Can LLM Agents Truly Evolve Their Capabilities?
论文摘要
在五个领域各构造了 100 个逐步变难、且经验可复用的子任务。发现顺序执行通常能提升表现,但显式维护技能平均并未稳定超过普通上下文适应,较弱模型还会积累更多碎片化的专用技能。
arXiv
2026
效果评测
What Is a Skill Worth? Structure-Aware Shapley Valuation of Agent Skills
论文摘要
把长技能拆成内部结构单元,用结构感知的 Shapley 值(一种衡量各部分边际贡献的方法)估计每个步骤或规则对整体表现的贡献,可用于删减冗余、定位负贡献内容和解释自动优化结果。
arXiv
2026
效果评测
Skill-Use: Can LLMs Actually Use Skills in Agentic Harnesses?
论文摘要
先只给智能体技能名称和短描述,要求它自行检索完整流程,再分别评估触发(Trigger)、遵循(Compliance)与边界(Boundary)。79个技能、177个任务、8个模型和2套运行框架的结果显示,最强配置得分仅0.613,且模型排名随框架改变。
arXiv
2026
效果评测
SkillTV-Bench: Benchmarking How Well Judges Perform on Skill-Augmented Agentic Execution
论文摘要
把评测对象从最终回答扩展到完整执行轨迹,专门检查不同评判模型能否识别工具误用、步骤跳过、边界违反和表面成功,从而评估这些评判模型作为技能优化奖励信号是否可靠。
arXiv
2026
效果评测
SkillEval: Decomposing Agent Skill Quality into Interpretable Signals
论文摘要
不只看下游任务是否成功,而是从受控的正负技能对中学习文档质量属性的方向,把新技能投影成可解释分数,并显式降低长度与格式等无关特征的影响;这可用于提前诊断技能弱点并指导修改。
arXiv
2026
效果评测
Agent Skills Can Be Harmful: An Empirical Study of Skill-Induced Failures in LLM Agents
论文摘要
利用有技能与无技能(或语义不匹配技能)的配对运行,对 307 个技能诱发的失败案例进行归因,涵盖功能错误和效率回退。结果显示,看似相关的技能仍会让智能体遗漏任务要求,过度验证和重型流程也会增加成本。
05
READING STAGE 05
技能的安全与隐私
检查第三方技能、个人信息泄露、恶意执行记录、后门和多技能组合带来的风险。
8 篇
arXiv
2026
安全与隐私
Agent Skill Security: Threat Models, Attacks, Defenses, and Evaluation
论文摘要
论文建立了覆盖技能入库、检索、选择、执行和更新全生命周期的威胁模型,并用 327 个真实技能构建了 SkillSec-Eval 评测集。研究发现安全风险不只出现在代码执行阶段,而是贯穿整个使用流程。
arXiv
2026
安全与隐私
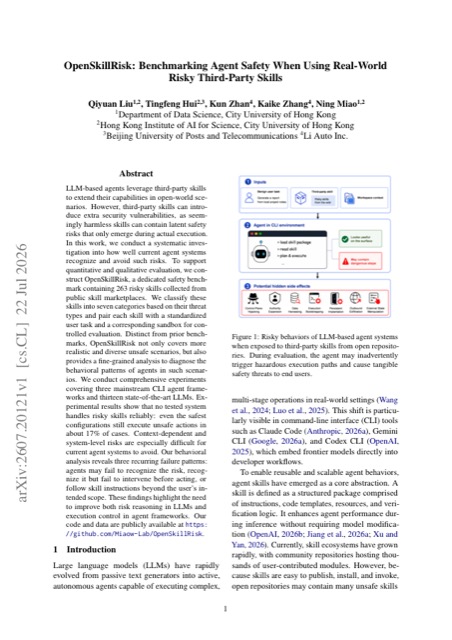
OpenSkillRisk: Benchmarking Agent Safety When Using Real-World Risky Third-Party Skills
论文摘要
OpenSkillRisk 从真实第三方技能中构造风险场景,测试智能体能否识别危险权限、拒绝越权操作并保持任务可用。研究发现智能体在安装和执行带有误导流程或不安全资源的技能时,风险识别能力有限。
arXiv
2026
安全与隐私
When Agents Learn to Be You: Benchmarking Privacy Leakage, Impersonation Risk, and Defenses in Persona Skills
论文摘要
论文研究将个人交互历史压缩成可携带的 Persona Skill(人设技能)后,分散的隐私信息如何被集中并支持身份模仿。基准测试同时检查敏感信息泄露、冒用风险与防御措施对个性化效果的影响。
arXiv
2026
安全与隐私
When Experience Becomes Instruction: Trajectory Poisoning in Self-Evolving Agent Skill Systems
论文摘要
PoisonedEvolution 利用自进化系统会将执行经验转化为持久指令的机制,在轨迹中植入恶意行为模式。攻击效果会延续到后续的技能生成、检索和新会话执行中。
arXiv
2026
安全与隐私
When Self-Evolution Backfires: Pre-Commit Gating against Skill Contamination in LLM Agents
论文摘要
论文发现技能池增长并非单调提升,新技能超过某个规模后可能污染检索与执行。Pre-Commit Gate(提交前门控)在写入持久库前比较候选技能的收益、回归和跨任务影响,只提交通过验证的更新。
arXiv
2026
安全与隐私
ElasticBack: Stealthy Conditional Backdoor in LLM-Agent Skills via Coupled Trigger-Rule Optimization
论文摘要
ElasticBack 将触发条件与恶意规则联合优化,使技能在常规检查中表现正常,只在特定语义或状态组合出现时改变行为。这揭示了技能供应链中难以靠静态文本扫描发现的条件后门。
arXiv
2026
安全与隐私
Practice Makes Unsafe: Skill Misevolution in Self-Improving LLM Agents
论文摘要
SkillMisevo-Bench 版本化跟踪恶意暴露如何经技能编写、检索和后续执行形成持久伤害。实验显示安全的执行结果也可能被错误固化,SafeEvolve 因此同时管控写入内容和未来复用。
arXiv
2026
安全与隐私
CompoSkill: Compositional Skill Chain Attacks from Individually Scanner-Passing LLM Agent Skills
论文摘要
CompoSkill 展示多个单独通过安全扫描的技能仍可在组合后形成恶意链条,攻击依赖技能间的数据流和执行顺序。这说明按包独立认证不能保证整个技能组合的安全。
06
READING STAGE 06
技能怎么持续改进
研究怎样根据真实执行结果修改技能,同时用测试、版本记录和回滚避免越改越差。
9 篇
arXiv
2026
持续改进
SkillOpt: Executive Strategy for Self-Evolving Agent Skills
论文摘要
SkillOpt 把技能当作可训练的外部状态,由独立优化器根据评分对技能文档执行增、删、改操作,只有在留出集上严格提升才接受更新。文本学习率、编辑缓冲区和慢速元更新把随意的自我修改变成可复现的优化过程。
arXiv
2026
持续改进
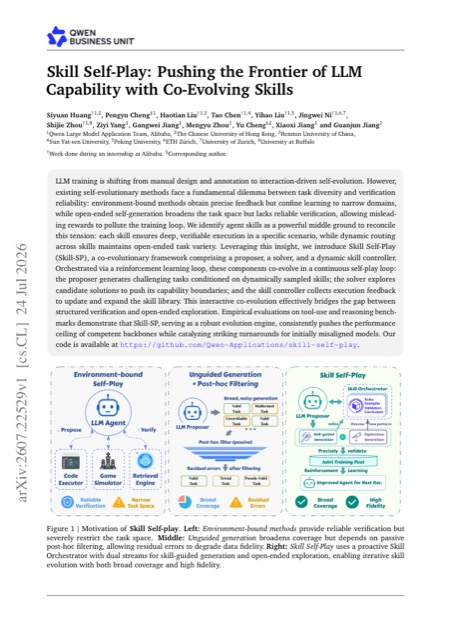
Skill Self-Play: Pushing the Frontier of LLM Capability with Co-Evolving Skills
论文摘要
Skill Self-Play 让任务提出者、求解器和技能控制器在强化学习中共同进化:提出者生成可验证的挑战,求解器探索解法,控制器从执行反馈扩展技能库。技能成为连接任务多样性与可靠验证的中间层。
arXiv
2026
持续改进
SkillRise: Agentic Reinforcement Learning for Cross-Task Skill Evolution
论文摘要
SkillRise 识别跨任务共享的解题模式,让技能的产生、选择和更新进入强化学习循环,而不是把相关任务当作独立回合。这减少了重复探索并提高了向新任务的迁移能力。
arXiv
2026
持续改进
Rethinking Self-Evolving Agent Skills: Feedback Dynamics over Multiple Rounds
论文摘要
受控实验固定执行器、优化器、验证规则和轮数,只改变成功或失败反馈。388 个候选中仅 55 个形成新的验证最优,说明技能进化更像稀疏、依赖验证过滤的搜索,而不是随轮数稳定上升。
arXiv
2026
持续改进
SkillHEX: Improving Agent Skills via Hypothesis-Driven Autonomous Exploration and Exploitation
论文摘要
SkillHEX 把技能维护写成假设驱动的探索与利用循环:先根据失败提出可检验的改进假设,再主动选择能区分假设的任务执行,用验证结果决定扩展、修订或保留已有程序。
arXiv
2026
持续改进
SkillProx: Self-Evolving Agent Skills via Proximal Textual Gradient Descent
论文摘要
SkillProx 把技能进化分成前向诊断更新与后向精简:前向阶段在同一批任务上重跑修改、测量结果并回滚退化,后向阶段拆成可审计的知识单元,用留一效用决定保留、降级或删除。目标不只是加内容,也要控制复杂度和污染。
arXiv
2026
持续改进
SkillCommit: Evolving Agent Skills through Behaviorally Validated Scope Expansion
论文摘要
SkillCommit 先把新经验保存为局部补丁,只在跨实例重放和机制检查确认行为兼容后,才抽象成更高层技能并提交。这种扩大行为验证范围的做法,避免了仅凭语义相似就合并互不兼容的程序。
arXiv
2026
持续改进
Write, Execute, Refine: From Skill Followers to Skill Optimizers via Reinforcement Learning from Execution Feedback
论文摘要
WER 将技能优化器放在执行器之外:优化器写技能,执行器多次运行,验证器评分,再把同一技能的成功与失败轨迹配对成下一阶段训练状态。这让模型从自己先前技能的真实后果中学习,而不是只在推理时临时修改。
arXiv
2026
持续改进
WikiSkill: Compiling Agent Experience into Persistent Knowledge for Skill Evolution
论文摘要
WikiSkill 在执行记录和可执行技能之间加入持久 wiki,由维护器整理反复出现的失败、策略和适用条件,再让技能提议器据此更新技能。实验显示,保留并复用这些中间知识比每轮只改技能更稳定。
没有找到匹配的论文,试试“检索”“评测”“安全”或“持续改进”。
专题依据论文原始页面整理,收录截止 2026 年 9 月 27 日。2026 年新作多数仍是 arXiv 预印本,页面中的数值来自论文作者,不代表已经被其他团队复现。比较结果时,请检查基础模型、工具权限、任务集和评分方式是否一致。
阅读提示
Agent Skills 专题阅读导览
这组问答解释技能、工具、记忆和工作流之间的边界,并梳理技能发现、组合、评测与持续更新的关键问题。
相关概念:Agent Skills、技能库、工具调用、程序记忆、技能检索、组合规划、安全更新
Agent Skill 与普通工具调用有什么区别?
工具提供可调用的外部能力,Skill 则通常封装何时调用、如何组合步骤、需要哪些上下文以及怎样检查结果。一个 Skill 可以使用多个工具,也可以只包含可复用的策略、模板和验证流程。
Skill 与长期记忆之间是什么关系?
长期记忆保存事实、经历或用户偏好;Skill 保存可重复执行的行为模式。经验可以被总结成 Skill,Skill 的执行结果也可以写回记忆,但两者在检索目标、生命周期和安全审查上并不相同。
自动生成或更新 Skill 时最大的风险是什么?
主要风险包括错误步骤被固化、权限范围扩大、提示注入进入持久资产,以及新 Skill 破坏既有任务。稳健流程需要来源审查、沙箱执行、独立评测、版本记录和失败回滚。